L’analyse de données de performance, telles que les Expected Goals (xG) ou les classements détaillés, exige des sources fiables et structurées. Scraper les statistiques sportives avec Python et BeautifulSoup constitue une approche technique standard pour constituer des bases de données sur mesure. Toutefois, l’extraction de ces informations publiques se heurte aujourd’hui à des pare-feux stricts.
Ce tutoriel détaille la construction d’un script d’extraction moderne, adapté aux contraintes de sécurité de septembre 2026. L’objectif est de vous montrer comment outrepasser les protections anti-robot récentes pour collecter le code HTML, avant de nettoyer et d’exporter ces données brutes vers un format exploitable.
En bref : la synthèse pour scraper des données sportives en 2026
Voici l’essentiel pour extraire efficacement les métriques athlétiques face aux pare-feux actuels.
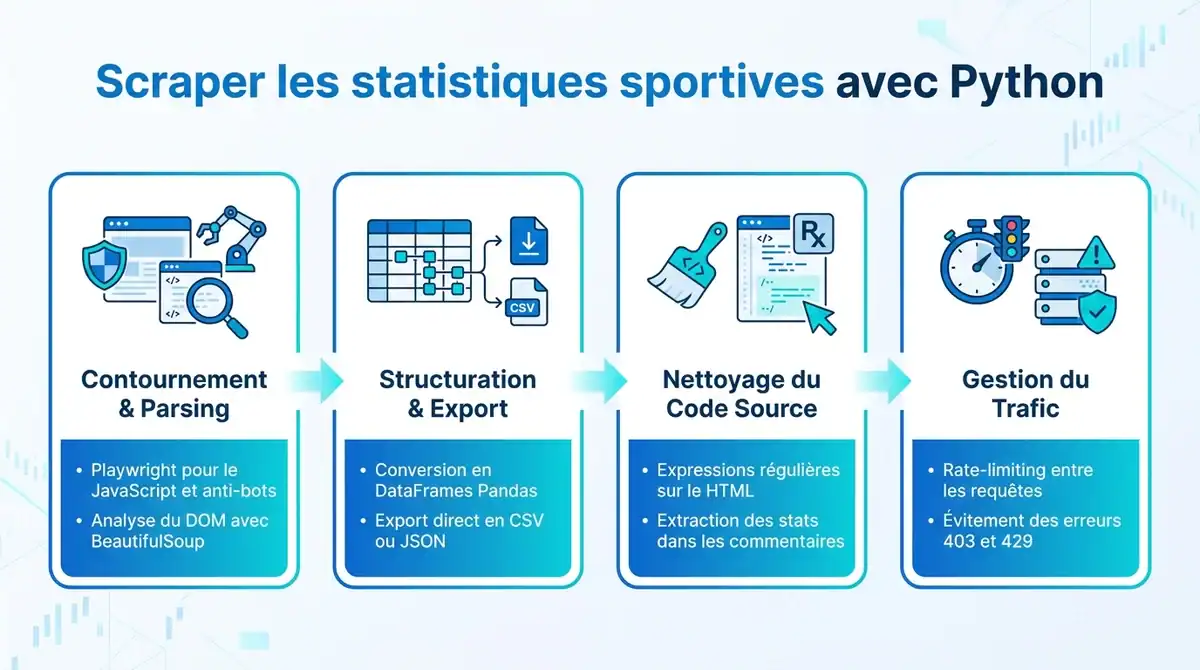
- Associez Playwright pour exécuter le JavaScript et franchir les verrous anti-bot, avant de confier l’analyse du DOM à BeautifulSoup.
- Transformez automatiquement les tableaux extraits en DataFrames avec Pandas pour garantir un export immédiat en CSV ou JSON.
- Nettoyez systématiquement le code source avec des expressions régulières pour révéler les statistiques dissimulées dans les commentaires HTML.
- Anticipez les erreurs HTTP 403 et 429 en appliquant un rate-limiting rigoureux entre vos requêtes réseau.
Pourquoi BeautifulSoup seul ne suffit plus face aux protections actuelles
L’extraction d’informations sur les plateformes sportives modernes exige une approche hybride. Les outils traditionnels se heurtent désormais à des architectures web dynamiques et hautement sécurisées.
Le blocage réseau et l’exécution JavaScript
Les requêtes HTTP basiques initiées via le module requests sont fréquemment stoppées au niveau réseau par des pare-feux comme Cloudflare Turnstile ou DataDome. Ces systèmes de protection analysent plus de 12 vecteurs d’empreinte, dont le fingerprinting TLS/JA4, et renvoient immédiatement une erreur HTTP 403 ou une page de défi.
Parallèlement, la bibliothèque beautifulsoup4 reste un parseur statique dépourvu de moteur d’exécution JavaScript. Face aux sites sportifs actualisés en direct via WebSocket ou construits en React, une requête initiale ne retourne généralement qu’un squelette HTML incomplet.
Pour pallier ces limites, environ 68 % des projets d’extraction de données complexes combinent désormais plusieurs outils. L’intégration d’un navigateur automatisé comme Playwright permet de franchir les sécurités et de générer le DOM complet, bien que cette méthode exige environ 200 Mo de RAM par onglet actif contre 50 Mo pour une simple requête.
Le traitement des tableaux statistiques dissimulés
Dans cette architecture moderne, BeautifulSoup n’intervient qu’en fin de chaîne pour structurer le code HTML préalablement rendu par le navigateur headless. Son rôle se concentre strictement sur le ciblage des balises et l’extraction des métriques.
Une particularité d’ingénierie fréquente sur les sites de statistiques historiques complique cette étape. Plusieurs tableaux de performances athlétiques sont volontairement masqués à l’intérieur de commentaires HTML pour différer leur affichage côté client.
Il est donc impératif de nettoyer le code source avant l’analyse. L’application d’une expression régulière via le module Python natif, comme re.sub("<!--|-->", "", html), permet de désarchiver ces données enfouies et de les rendre lisibles par le parseur.
Prérequis et installation de l’environnement Python
La préparation d’un espace de travail isolé garantit la stabilité des scripts d’extraction. Scraper les statistiques sportives avec Python et BeautifulSoup nécessite une base technique moderne pour gérer le rendu dynamique et la structuration des données.
Le respect de ces étapes d’initialisation permet d’éviter les conflits de dépendances lors du déploiement du code.
Étapes de configuration du projet
- Vérification de l’interpréteur : Le développement s’appuie idéalement sur Python 3.12 ou supérieur. La version de maintenance 3.14.7, publiée en août 2026, offre des performances optimales pour le traitement de données massives.
- Création de l’environnement virtuel : L’isolation des paquets s’effectue via le module natif
venvou un outil récent commeuv.# Création et activation de l'environnement virtuel python -m venv env_scraping source env_scraping/bin/activate # Sur Windows : env_scraping\Scripts\activate - Installation des bibliothèques d’analyse : Le gestionnaire
pippermet de récupérerbeautifulsoup4(version stable 4.15.0). Il est recommandé de lui associer le parseur Clxml, nettement plus rapide que lehtml.parsernatif pour parcourir les arbres DOM complexes.# Installation des parseurs HTML/XML pip install beautifulsoup4==4.15.0 lxml - Ajout des modules de requêtage et de structuration : Le client
requests(version 2.34.2) gère les appels HTTP basiques. La bibliothèquepandasest requise pour transformer les balises de tableaux en DataFrame manipulables.# Installation du client HTTP et de Pandas pip install requests==2.34.2 pandas - Configuration de l’automatisation : Le paquet
playwrightpilote la navigation headless pour contourner les pare-feux. Une fois le module installé, le téléchargement du moteur Chromium est obligatoire pour exécuter le JavaScript des plateformes cibles.# Installation de Playwright et de ses binaires pip install playwright playwright install chromium
Scraper les statistiques sportives avec Python et BeautifulSoup : le tutoriel pas à pas
Pour scraper les statistiques sportives avec Python et BeautifulSoup, il est indispensable d’adopter une approche séquentielle. Ce processus combine la navigation automatisée pour déjouer les protections réseau et l’analyse ciblée du code source.
Voici la méthode complète pour extraire, nettoyer et structurer ces métriques de performance en toute sécurité.
Le script complet d’extraction et de structuration
- Contournement JavaScript et récupération HTML : L’utilisation de Playwright permet de charger la page complète, y compris les éléments générés dynamiquement, là où une simple requête HTTP échouerait.
- Gestion du rate-limiting et des erreurs : L’intégration de pauses préventives et la vérification stricte des codes de réponse préviennent les bannissements liés aux erreurs HTTP 403 et 429.
- Parsing et nettoyage du DOM : Le module natif d’expressions régulières supprime les balises de commentaires qui masquent souvent les tableaux de données, avant de confier l’arbre DOM au parseur rapide.
- Conversion Pandas et export CSV : La balise de tableau isolée est transformée instantanément en DataFrame, facilitant le nettoyage final et la sauvegarde locale.
import time
import re
import io
import pandas as pd
from bs4 import BeautifulSoup
from playwright.sync_api import sync_playwright

def extraire_donnees_match(url):
    with sync_playwright() as p:
        # Étape 1 : Lancement du navigateur headless
        browser = p.chromium.launch(headless=True)
        page = browser.new_page()

        # Étape 2 : Rate-limiting (pause préventive avant la requête)
        time.sleep(3)

        # Navigation vers la page cible
        reponse = page.goto(url, wait_until="networkidle")

        # Gestion explicite des erreurs HTTP fréquentes
        if reponse.status in [403, 429]:
            print(f"Échec HTTP {reponse.status} : Protection anti-bot ou limite atteinte.")
            browser.close()
            return None

        code_source = page.content()
        browser.close()

        # Étape 3 : Nettoyage des commentaires HTML masquant les tableaux
        html_propre = re.sub(r"<!--|-->", "", code_source)

        # Parsing avec BeautifulSoup et lxml
        soup = BeautifulSoup(html_propre, "lxml")
        tableau_stats = soup.find("table", {"class": "stats_table"})

        if tableau_stats:
            # Étape 4 : Transformation en DataFrame via StringIO (standard Pandas)
            html_io = io.StringIO(str(tableau_stats))
            df = pd.read_html(html_io)[0]

            # Exportation des données structurées
            df.to_csv("performances_xg.csv", index=False)
            print("Export CSV réussi.")
            return df

        return None
Comparatif des méthodes de collecte de données sportives
Avant de scraper les statistiques sportives avec Python et BeautifulSoup, l’évaluation de l’architecture technique constitue une étape décisive. La stratégie retenue influence directement la consommation des ressources serveur et la pérennité du flux d’informations.
Le tableau ci-dessous confronte les quatre approches majeures utilisées pour extraire des métriques athlétiques, classées selon leurs contraintes opérationnelles.
| Méthode d’extraction | Coût financier | Fiabilité face aux blocages | Complexité technique | Cas d’usage optimal |
|---|---|---|---|---|
| Parsing statique (Requests + BS4) | Nul | Faible (vulnérable aux erreurs 403/429) | Basse | Archives historiques (Transfermarkt) |
| Scraping dynamique (Playwright) | Nul (forte charge CPU/RAM) | Élevée (contournement JS) | Haute | Plateformes interactives (Capology) |
| Interception réseau (XHR/Fetch) | Nul | Moyenne | Modérée | Endpoints JSON internes (SofaScore) |
| APIs professionnelles (API-Football) | Freemium | Maximale (aucune restriction) | Très basse | Scores en temps réel |
Analyse des performances et des coûts
Le parsing HTML statique reste la solution la plus rapide pour récupérer des historiques de matchs. Toutefois, cette méthode montre rapidement ses limites face aux pare-feux applicatifs modernes, entraînant des rejets de connexion fréquents si le rate-limiting n’est pas rigoureusement calibré.
L’automatisation via un navigateur headless résout le problème du rendu JavaScript. Cette fiabilité accrue se paie par une latence supérieure et une exigence matérielle plus stricte pour maintenir les sessions actives lors de la collecte.
L’interception des requêtes internes représente une voie hybride astucieuse. En écoutant le trafic réseau d’applications comme FotMob, le script récupère directement des objets JSON structurés, évitant ainsi la lourdeur d’une analyse DOM complète.
Pour les projets nécessitant du temps réel, les interfaces de programmation spécialisées comme Sportmonks s’imposent. Elles délivrent des flux de données avec une latence comprise entre 1,5 s et 2,5 s sur les événements en direct.
Ces services tiers proposent généralement un niveau d’accès gratuit incluant jusqu’à 5 000 appels, offrant une alternative stable aux scripts d’extraction complexes.
Foire aux questions sur la collecte de données sportives
- Quelle est la légalité du scraping de statistiques sportives publiques au regard du droit des bases de données ?
- L’extraction d’informations factuelles comme les scores ou les classements reste généralement autorisée si elle ne nécessite pas de contourner un système d’authentification. Les développeurs doivent impérativement consulter le fichier robots.txt du domaine ciblé avant toute opération automatisée. Il convient également de se conformer aux lignes directrices 2026 publiées par le Comité européen de la protection des données (EDPB). Si les faits bruts échappent au droit d’auteur, l’aspiration systématique d’une architecture entière peut violer le droit sui generis protégeant les producteurs de bases de données.
- Comment éviter les bannissements d’adresse IP causés par un taux de requêtes trop élevé ?
- Les infrastructures modernes identifient rapidement les comportements automatisés et bloquent les adresses IP générant un volume de requêtes irréaliste. L’intégration de proxys rotatifs constitue une première parade technique pour diluer l’empreinte réseau du script. Une approche plus sûre consiste à analyser le fonctionnement de Flashscore ou d’autres fournisseurs via leurs flux de données officiels. Des plateformes spécialisées comme SportsDataIO mettent à disposition des API structurées, avec des forfaits de démarrage fixés à 0 € par mois pour valider des concepts techniques sans risque de bannissement.
- Pourquoi certains tableaux statistiques sont-ils absents lors de l’inspection initiale du code source ?
- Les concepteurs web dissimulent fréquemment les grilles de données volumineuses à l’intérieur de balises de commentaires HTML afin d’optimiser le temps de chargement initial. La bibliothèque beautifulsoup4 (maintenue en version 4.15) affiche un taux d’adoption de 43,5 % chez les développeurs, mais elle ignore ces blocs commentés lors de l’analyse standard du DOM. Pour scraper les statistiques sportives avec Python et BeautifulSoup dans ce contexte précis, une étape de nettoyage préalable du code source via le module d’expressions régulières s’avère indispensable pour exposer les balises de tableau au parseur.
Conclusion et recommandations pour pérenniser vos scripts
Concevoir une architecture d’extraction fiable repose sur la séparation des tâches entre la récupération du DOM et son analyse. Scraper les statistiques sportives avec Python et BeautifulSoup exige aujourd’hui d’associer un navigateur headless pour le rendu dynamique et un parseur statique pour cibler les balises HTML.
La pérennité de vos outils dépend d’une maintenance régulière. Les plateformes modifient fréquemment la structure de leurs classes CSS ou leurs identifiants. L’encapsulation de vos sélecteurs dans des variables de configuration facilite les mises à jour sans altérer la logique de votre DataFrame Pandas.
Une démarche d’automatisation implique également une responsabilité technique. L’espacement de vos requêtes réseau préserve la bande passante des serveurs cibles et limite les risques de blocage. Le respect strict des directives d’exploration garantit une approche éthique, assurant la viabilité de vos projets d’analyse sur le long terme.